Claves de pago, bases de datos médicas y accesos root: todo estaba en un archivo de Claude Code
Los desarrolladores lo subieron a GitHub sin saber que guardaba sus contraseñas en texto plano

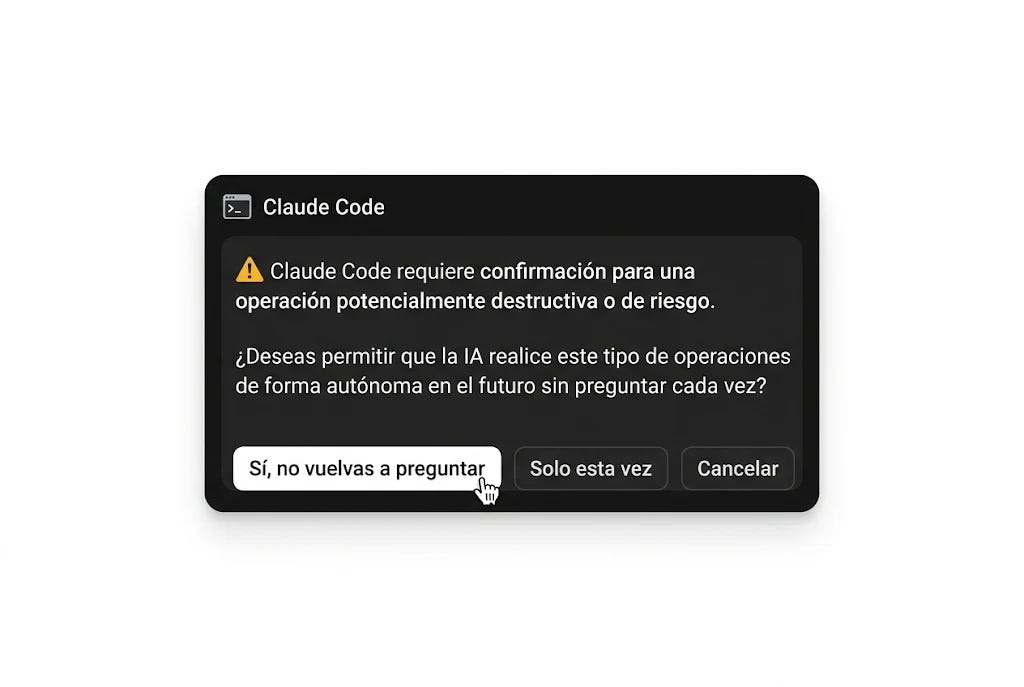
Pulsar “Sí, no vuelvas a preguntar” en Claude Code puede tener consecuencias devastadoras. Según un estudio de Apiiro publicado el 5 de noviembre, hay 2.539 secretos reales en 1.994 repositorios públicos.
Se trata de contraseñas de bases de datos, claves de servicios en la nube y tokens de acceso, es decir, las credenciales con las que un programa se identifica ante otro.
La mayoría pertenecen a desarrolladores particulares, aunque también hay 63 organizaciones afectadas, desde grupos de estudiantes hasta empresas de software.

En 539 casos, el cambio llevaba la firma de Claude
El problema nace en cómo Claude Code pide permiso. Cuando necesita, por ejemplo, consultar una base de datos, propone un comando que incluye la contraseña. Si el usuario le dice que no vuelva a preguntar, la herramienta guarda ese comando de forma exacta, con el secreto dentro, en un archivo de la carpeta del proyecto.
Si nada lo impide, ese archivo se sube a GitHub con el resto del código. De las 104.185 copias públicas que ha localizado Apiiro, 1.122 contienen un secreto real. Además, en 539 de los repositorios rastreados, el cambio que modificó el archivo era un commit (un registro de cambios en el código) coescrito por Claude.
Boris Cherny, responsable de Claude Code en Anthropic, respondió el 7 de noviembre en Hacker News. Según explicó, la herramienta excluye el archivo de Git al crearlo, así que, a su juicio, las copias expuestas se subieron a mano. Aun así, aseguró que están estudiando soluciones, como que el modo automático detecte estos casos o incorporar un escáner básico de secretos.
Esto es lo que de verdad importa 👇
Tras leer el informe, hay al menos 4 puntos que me parecen relevantes y que nos ayudan a entender cómo evoluciona esta tecnología:
La culpa no es de la herramienta. No entiendo que haya gente que dude de esto. Vale, los agentes permiten desarrollar más rápido, pero cualquiera con conocimientos sabe que un LLM puede alucinar, fallar y liarla de verdad. Echarle la culpa a la tecnología a mí me parece una excusa. Ya sea por pereza o por desconocimiento, el foco tiene que ir al desarrollador.
Es el precio de la democratización. Hace un rato te contaba cómo dos horas de agentes de IA bastaron para meter Windows 11 en un iPhone y defendía que la IA acerca la programación a mucha más gente. Bajo mi punto de vista, esta noticia es la otra cara de la moneda. Ir demasiado deprisa en la mayoría de los contextos (no para un experimento personal, por ejemplo) es un error mayúsculo.
Nos hemos vuelto vagos. Así de simple. Lo fácil es decirle a la IA que vaya haciendo sin revisar nada. Y yo no creo que la tecnología esté preparada para ese nivel de abstracción.
Toca delegar con cabeza. Quizá sea el momento de dejar de mandarles ciertas cosas a los agentes y de no delegar en ellos de forma indiscriminada.
Y tú, ¿lees cada comando antes de aprobarlo o ya pulsas “no volver a preguntar” por costumbre? Cuéntamelo en los comentarios.
Discusión sobre este post